



从世界模型到 Robotaxi,Momenta 想要把「物理 AI」推向量产丨北京车展
过去几年,智能驾驶的竞争一直在更换叙事逻辑。
最早的讨论集中在硬件上:激光雷达要不要上,摄像头够不够用,算力平台有没有冗余。随后,行业焦点转向了算法架构,从规则驱动到 BEV,从感知、预测、规划分模块协同,再到端到端大模型,自动驾驶逐渐摆脱了过去那套层层拼接的工程系统,开始更像一个能够从数据中学习经验的智能体。
但对汽车来说,智能驾驶始终和纯粹的数字世界不同。大语言模型可以在文本中预测下一个 token,智能驾驶系统面对的却是一个连续、复杂、不可暂停的物理世界:前车掉落的物体会滚向哪里,路边的行人是否会突然横穿,雨天路面会怎样影响制动距离,拥挤路口的每一辆车、每一个人都在改变下一秒的局势。
这也是「世界模型」被越来越多自动驾驶公司提到台前的原因。它所要解决的不只是让车看见更多场景,还有让车理解场景背后的物理规律和因果关系。4 月 25 日,Momenta 在北京车展举办「Momenta R7,物理 AI 序章」主题分享会,正式宣布 Momenta R7 强化学习世界模型量产首发,也把自己的技术叙事从智能驾驶,进一步推进到「物理 AI」。
世界模型:让汽车理解真实世界的变化
在 Momenta 的技术表达中,世界模型和强化学习构成了物理 AI 的两大支柱。
Momenta 合伙人、CEO 曹旭东在现场提到,预测是智能进化的核心基石。大语言模型依靠 Next Token Prediction 压缩数字世界的常识,让 AI 获得理解和生成语言的能力;世界模型则通过 World Model Prediction,预测物理世界未来的状态与交互逻辑,让系统理解物体的物理属性、运动因果以及不同主体之间的潜在互动。
这句话放在智能驾驶语境里,可以理解得更直观一些:过去很多系统善于处理「见过」的场景,因为数据集中有类似样本,规则库里有对应策略。但真实道路的复杂性,恰恰来自那些不完全重复的瞬间。一个纸箱、一个塑料袋、一箱散落的苹果,看起来都只是障碍物,但它们的形态、重量、滚动轨迹、扩散范围并不相同。人类驾驶员之所以能处理这些突发情况,是因为我们对物理世界有长期经验:轻的东西会被风吹动,圆的东西会滚动,潮湿路面制动距离会变长。
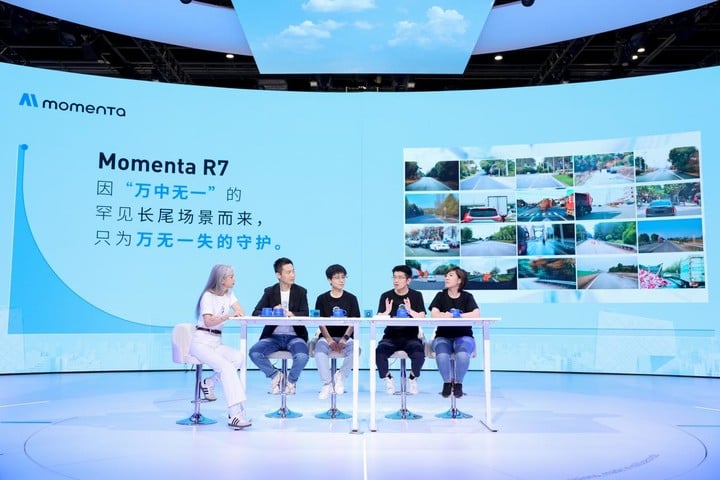
Momenta R7 强化学习世界模型要补上的,就是这类对物理世界的理解。
按照 Momenta 合伙人、研发 SVP 夏炎的介绍,Momenta 的世界模型分为三个层次。第一层是世界模型预训练,通过海量真实驾驶数据训练模型,把物理规律、道路常识和因果关系压缩进系统之中。它解决的是基础认知问题:车不仅知道画面里有什么,也要知道这些东西大概率会怎样变化。
第二层是世界模型仿真。与传统仿真相比,世界模型仿真更像一个可推演的虚拟道路环境。系统不只是复现一段道路视频,而是可以根据自车行为变化,推演外部世界的后续演变。换言之,车辆可以在虚拟环境里尝试不同决策,并观察这些决策带来的连锁反应。
第三层是在世界模型中进行强化学习。强化学习的价值,在于让 AI 在目标和反馈中反复试错、自主优化。现实世界不能让一辆车随意试错,极端场景也不会高频出现,但在世界模型构建的虚拟训练场里,系统可以经历千万次推演,把真实道路上罕见的长尾问题提前演练。
这也是 Momenta 此次发布中最重要的技术转向:智能驾驶从「模仿人类」进一步走向「自主探索」。模仿学习能够从人类驾驶数据里学习常规经验,但面对数据中极少出现、甚至从未出现过的场景,它的边界会逐渐显现。世界模型与强化学习结合之后,系统获得了某种「想象」能力,可以在虚拟环境中推演没有充分出现过的情况,并不断寻找更优解。
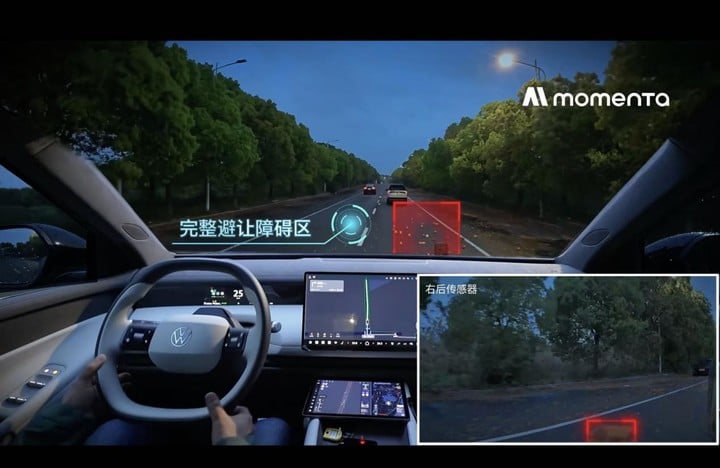
Momenta 合伙人、研发 SVP 孙刚在发布会上举了一个例子:如果前车意外掉落一箱苹果,系统需要判断的不是「前方有障碍物」这么简单,而是苹果会如何滚动、扩散,车辆应该怎样减速、避让,才能兼顾安全、平顺和效率。这里考验的已经不是单点识别能力,而是对物理运动规律和交通博弈的综合理解。
对普通用户来说,世界模型听上去仍然很技术,但它最终落到驾驶体验上,其实是一种更稳定的安全感。车辆不只在天气晴朗、车道线清晰、交通秩序良好的情况下表现流畅,也要在城中村、晚高峰、突发障碍物、混合交通等复杂场景下,做出更接近成熟驾驶员的判断。这也是物理 AI 对智能驾驶的真正意义。
Robotaxi:从量产飞轮到全球商业化
如果说世界模型代表 Momenta 对下一代智能驾驶技术路线的判断,那么 Robotaxi 则是这套技术走向规模化商业落地的重要场景。
自动驾驶行业过去经历过多轮热潮,也经历过多轮降温。Robotaxi 曾经被视为自动驾驶最直接的终局,但高昂的车辆成本、复杂的城市运营、漫长的安全验证周期,让不少公司在商业化面前放慢了脚步。相比单独打造一支 Robotaxi 车队,Momenta 这些年更强调「一个飞轮」:通过量产辅助驾驶获得大规模真实数据,再反哺更高阶自动驾驶能力,最终推动 Robotaxi 落地。
这一路径的核心,是规模。
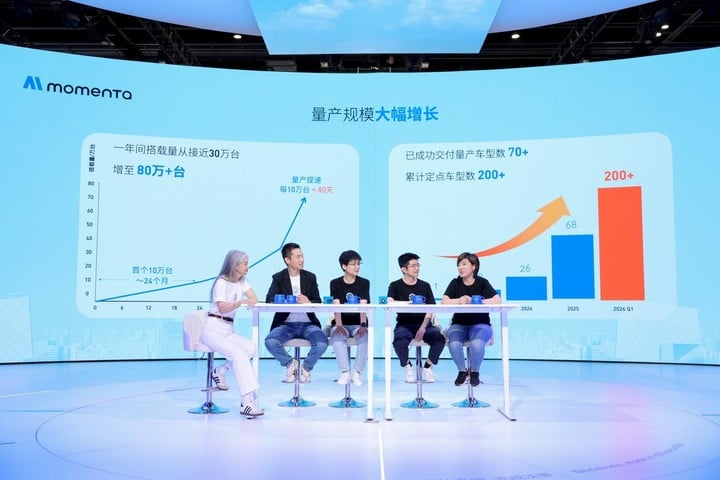
Momenta 合伙人、市场商务 SVP 孙环在发布会上介绍,目前搭载 Momenta 系统的量产车辆规模已经超过 80 万台。公司已经交付超过 70 款量产车型,累计定点车型数超过 200 款,量产落地覆盖十余个国家和地区。在本届北京车展上,超过 20 个品牌、60 余款车型搭载了 Momenta 智能辅助驾驶方案,其中包括梅赛德斯 – 奔驰、奥迪、宝马等品牌的新车型。
更值得注意的是交付速度的变化。2022 年,Momenta 完成首个 10 万台量产交付用了 24 个月;如今,最快不到 40 天即可完成 10 万台交付。这意味着,智能驾驶技术的竞争已经不只是算法榜单上的领先,也包括工程量产、供应链协同、车型适配和用户规模。只有当系统进入足够多真实车辆,才能形成持续迭代的数据闭环。
Robotaxi 的推进也在这个基础上展开。根据 Momenta 披露的信息,其 Robotaxi 全球生态已经与享道出行、智己汽车、Uber、梅赛德斯 – 奔驰、AutoGo、Lumo、Grab 等共享出行公司及主机厂达成合作,面向不同市场推进自动驾驶商业化服务。与此同时,Momenta 的方案已经在英国、挪威、新加坡、澳大利亚、新西兰等超过 10 个国家和地区落地。
这组信息背后,其实有两层变化。
第一,Robotaxi 正在从单一城市、单一车队的试运营,进入更多元的合作模式。主机厂提供车辆与制造能力,出行平台提供运营入口和用户场景,自动驾驶公司提供系统能力。没有任何一方可以单独完成全球化落地,协作网络本身正在成为自动驾驶商业化的一部分。
第二,中国自动驾驶公司开始把能力输出到全球市场。过去很长时间里,汽车工业的技术高地更多由欧美日企业定义;到了智能化阶段,中国市场复杂的道路环境、庞大的新能源车规模、快速迭代的软件生态,反而成为智能驾驶训练和落地的优势。Momenta 在北京车展谈「东方硅谷」,并不只是一个情绪化表达,它对应的是中国 AI 公司正在进入全球汽车智能化供应链的新阶段。
从世界模型到 Robotaxi,Momenta 这次北京车展分享会给出的核心信息,是物理 AI 不再停留在实验室叙事中。它一端连接底层算法,从预训练、仿真到强化学习,让系统更好理解真实世界;另一端连接量产和运营,通过 80 万台规模化车辆、200 多款定点车型和全球合作生态,把技术推进到真实商业场景里。
自动驾驶的终点不会只由一次发布会定义。真正重要的,是这些能力能否在更多车型、更多城市、更多气候和道路条件下稳定工作。对于 Momenta 来说,R7 强化学习世界模型的量产首发,是一条长路上的关键节点。对于整个行业来说,它也说明智能驾驶竞争正在进入新的阶段:下一轮比拼的核心,已经从「看得见」走向「想得明白」,再走向能否在真实世界中持续、安全、规模化地运行。