



我和我的 AI 手机吃了 3 顿饭
米其林三星餐厅潮上潮有一个特别的就餐模式「潮 1/2」:在餐厅后厨旁边放一张小餐桌,供少数人就餐,饭菜在主厨做好的瞬间即可上桌,最大程度地减少传菜过程中的风味和热量损耗,呈现出最好的味道。
对于讲究「一热顶三鲜」的中国人来说,这个就餐模式自有亲切感。
理解了这个,就可以理解高通推出的高带宽计算技术(High bandwidth compute,HBC)了。
把计算放到内存旁边,就像把饭桌放到厨房旁边去
当 ChatGPT 在屏幕上一个字一个字往外吐提问的答案时,我们会很自然地把速度归因于「计算」:CPU 更快一点、GPU 更强一点、NPU 多几十 TOPS,AI 应该就能回答得更快。
但实际情况不是这个样子的。
在 PC 时代,我们习惯看 CPU 的主频;智能手机刚兴起的时候,每个厂商都参与了「核战争」,比拼谁选的处理器核心数更多;后来游戏成为旗舰手机的重要战场,以及整个链条的重要收入来源,于是 GPU 性能和移动光追等指标开始备受关注。
计算性能就像汽车发动机的马力,数字越大,似乎总不会错。但是,AI 运行的时候,芯片里的 CPU、GPU 和 NPU 往往没有在全速工作。
它在等。等数据从内存里送过来。
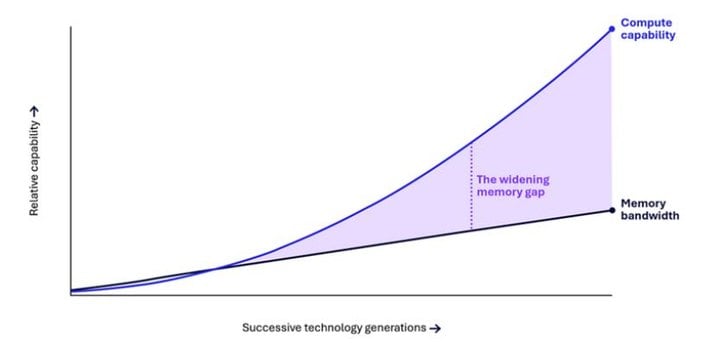
过去十年里,AI 计算能力和模型规模快速膨胀,但内存容量、带宽和数据搬运效率并没有以相同速度增长。最终,越来越多的时间和能耗花在数据移动上,而非真正的计算。
这就是「内存墙」,大语言模型因为这个「大」字,开始撞墙了。
一次生成式 AI 推理,大致可以分成两个阶段。第一阶段叫是Prefill,可以理解为「读题」。
用户给 AI 一份几十页的 PDF,或者告诉它「帮我总结过去一年和你的聊天记录」,模型首先需要把大量输入内容读进去。这部分工作会进行大量矩阵运算,所以计算能力依然非常重要。
到了第二阶段 Decode 的「答题」阶段,工作性质发生了变化。模型每生成一个 token,都需要不断读取模型参数以及之前累积下来的上下文,但实际进行的计算相对有限。
这就跟去餐厅吃饭一样,后厨的厨师已经炒好了 10 个菜,但是传菜员只有 1 个,那么从厨房(内存)到餐桌(计算)一次也就上一两个菜,根本不够吃。
问题的关键就是找到关键的问题:不是厨师不够,而是传菜员太少。
既然找到了关键的问题,那么产业就可以着手解决问题了,也诞生了不少方法。
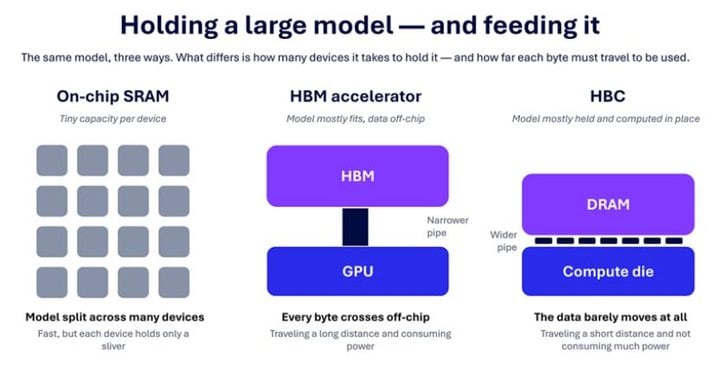
有一种技术路线是 SRAM(Static Random-Access Memory,静态随机存取存储器)就像是板前料理,把厨房搬到餐桌前,饭菜做好了就能端到食客面前。但是吃过板前料理的人也清楚,这种就餐模式菜单固定,并且价格一般还很贵。刚好,SRAM 的单位面积成本很高,很难用有限芯片面积装下越来越大的 AI 模型。
HBM(High Bandwidth Memory,高带宽内存)就像是寿司郎,后厨很大,就餐区也很大,后厨和就餐区之间有类似于「高速列车」一样的传送带,嗖嗖嗖地上菜。寿司郎的情况大家也看到了,排队极其夸张,想吃好也不算便宜,同理,先进 HBM 依赖复杂的堆叠和封装技术,成本高,供不应求。
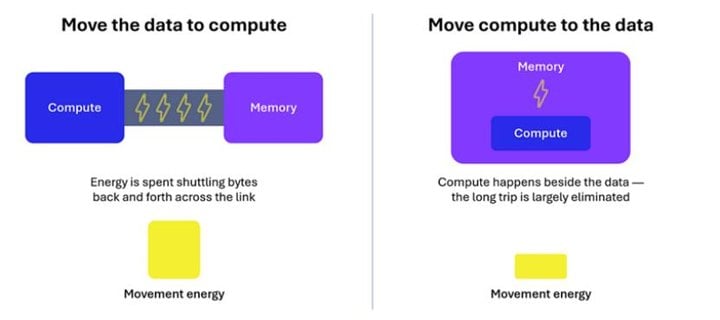
高通推出的高带宽计算技术(High bandwidth compute,HBC)是一种近内存计算架构思路,也就是前面说的「潮 1/2」,把餐桌(计算)搬到厨房(内存)那里去,减少数据和计算之间的搬运,从而加速 AI,减少功耗。
这其实和这么多年计算机产业的思考方向相悖的,过去是处理器越来越强,数据不断向处理器集中,但 AI 的发展迫使大家重新思考。当然,HBC 并不意味着以后所有计算都会跑进内存,Prefill (预填充)这样的高计算强度任务,依然需要强大的计算单元;游戏、视频编辑、影像处理同样不会消失。
大模型里的矩阵乘、向量运算、Embedding 查询、部分 Attention / KV Cache 相关操作,往往要读取大量数据,这些计算适合应用在 HBC 这里,也就是「数据搬运成本很高的计算」;CPU / GPU / NPU 依然负责「计算本身更复杂的任务」。
这本身也是一种异构分工。
HBC 技术虽然发布了,但商用还得一点时间,但针对 AI 对计算的新要求,以及旧需求旧模式依然很重要的情况,「异构分工」成为了一种核心的解题思路。
尤其是 AI 智能体手机这种新物种。
把 AI 计算放在最适合计算 AI 的地方去
如果手机只负责运行一个聊天机器人,事情其实会简单很多,做一颗巨大的 NPU,把模型塞进去,让它尽可能快地生成 token。
但要消费者接受的 AI 智能体手机显然复杂得多,它需要理解用户的个人情境,在多个应用之间运行,持续推理,并根据用户意图采取行动。未来更可能出现的,也不是一个庞大的模型包办所有事情,而是多个专用模型根据任务、情境和用户需求动态协作。
用户对手机说:
我晚上 7 点和朋友吃饭,帮我看看从公司过去会不会堵车,如果下雨就帮我叫车。顺便看看这家店有什么招牌菜,把朋友上次说不能吃的东西排除掉。
这句话背后可能发生一连串动作:识别语音;理解意图;读取日历;寻找餐厅信息;读取历史聊天上下文;调用地图;判断天气;必要时访问云端 API;最终再把结果呈现给用户。
其中既有大模型推理,也有操作系统调度、应用调用、网络通信、视觉和语音模型。
如果手机正在导航、录像或者运行游戏等等任务,事情还会更加复杂一些。所以 AI 智能体时代的芯片,并不会突然抛弃过去几十年建立起来的 CPU、GPU、NPU 分工。但是,CPU、GPU、NPU、缓存、内存乃至传感器中枢,都需要开始围绕 Agent 重新安排自己的位置。
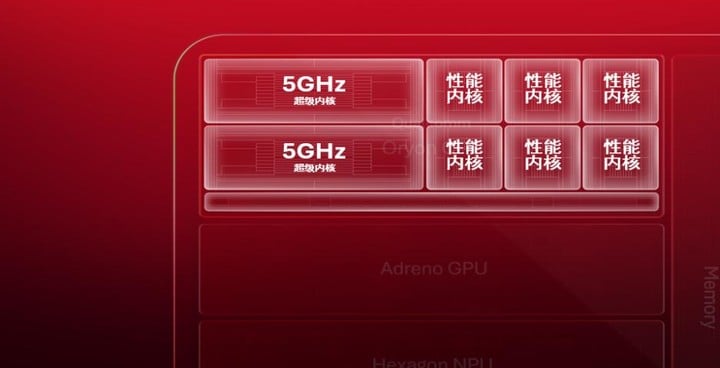
即将发布的下一代骁龙旗舰的 Qualcomm Oryon CPU 有适合放到标题里的的数字:5GHz,这是首个最高主频达到 5GHz 的移动 CPU,高通称之为全球最快的移动CPU。
如果放在十年前的「核战争」时期,这绝对是媒体报道的焦点,但今天,还有另一个抢戏的技术:Qualcomm Oryon FlexCache 可扩展缓存架构。
它让不同类型的核心可以共享一个缓存池,并根据任务动态获得更多空间。当超级内核突然面对重负载时,它可以使用更大的缓存;当任务在线程之间迁移时,相关数据也能继续留在缓存里,无需重新跑一趟系统内存。
为什么需要这个技术呢?
这是因为 AI 智能体的工作方式天然就是「跳来跳去」。智能体任务会先理解问题,再调用一个工具;工具返回结果之后,再规划下一步;随后可能切换另一个应用或者模型。
5GHz 和 FlexCache 其实是一体两面:前者让智能体任务跳得更快,后者让智能体任务跳得更轻松。
类似的,下一代 Adreno GPU 则直接加入了专门面向 AI 计算的 Adreno Matrix Cores(矩阵计算核心),就是集成在 Adreno GPU 内部、专门负责 AI/矩阵计算的硬件加速核心。
过去几年,AI 在手机 GPU 中扮演的角色越来越重要,超分辨率、帧生成、降噪,很多过去依赖传统图形算法完成的事情,开始交给神经网络。高通同时推出 Adreno Neural Fusion 神经网络融合渲染技术,可以把神经网络处理、AI 超级分辨率和 AI 帧生成统一到图形管线中。
DLSS、FSR 之类 PC 端显卡技术已经证明了每一个像素并不一定都需要传统图形管线「老老实实」算出来,其中一部分可以由 AI 猜出来。
传统方法想让游戏从 60 帧变成 120 帧,往往意味着 GPU 得干接近翻倍的活。但是 AI 帧生成提供了另一种选择:有些帧可以「生成」。
但 AI 进入图形管线之后,又产生了新的问题,神经网络计算需要数据。如果这些数据依然在 GPU、NPU、系统内存之间来回穿梭,省下来的计算可能又被搬运吃掉。
于是高通又在 GPU 旁边放了一块 18MB Adreno 独立高速显存 HPM,它可以存放渲染目标、颜色缓冲、深度缓冲、纹理以及中间结果,让更多图形和 AI 数据停留在 GPU 内部。
觉得听起来有点复杂?没关系,因为它还是熟悉的思路:让饭桌离厨房近一点。
说完 CPU 和 GPU,到了 Hexagon NPU 部分,这种思维模式转变就更加彻底。
下一代 Hexagon NPU 新增了 Element Accelerator,它专门针对 Transformer 工作负载设计;同时扩大共享内存,让更多模型状态、上下文以及 KV-cache 保留在靠近加速器的位置。
这里的 KV-cache 可以简单理解成 AI 的「工作记忆」。用户和 AI 聊得越久,它需要记住的上下文越多,这部分数据也就越来越大。如果每生成一个 token,都要跑到远处重新翻一遍聊天记录,速度自然会越来越慢。
你懂的,还是把饭桌搬到厨房旁边,在新一代 Hexagon NPU 上,大容量共享内存最高扩容 50%,目的就是减少访问 DDR 内存的次数。
与此同时,高通还和模型厂商合作,引入了混合专家模型(Mixture-of-Experts,MoE)构建新一代终端侧 AI 架构。这种灵活架构可以让一个 30B 的 MoE 模型在保持数百亿参数可用的同时,在 NPU 上每次生成一个词元仅需激活约 30 亿个被路由选中的参数,这种动态选择机制就可以减少实际计算负载和内存带宽需求。
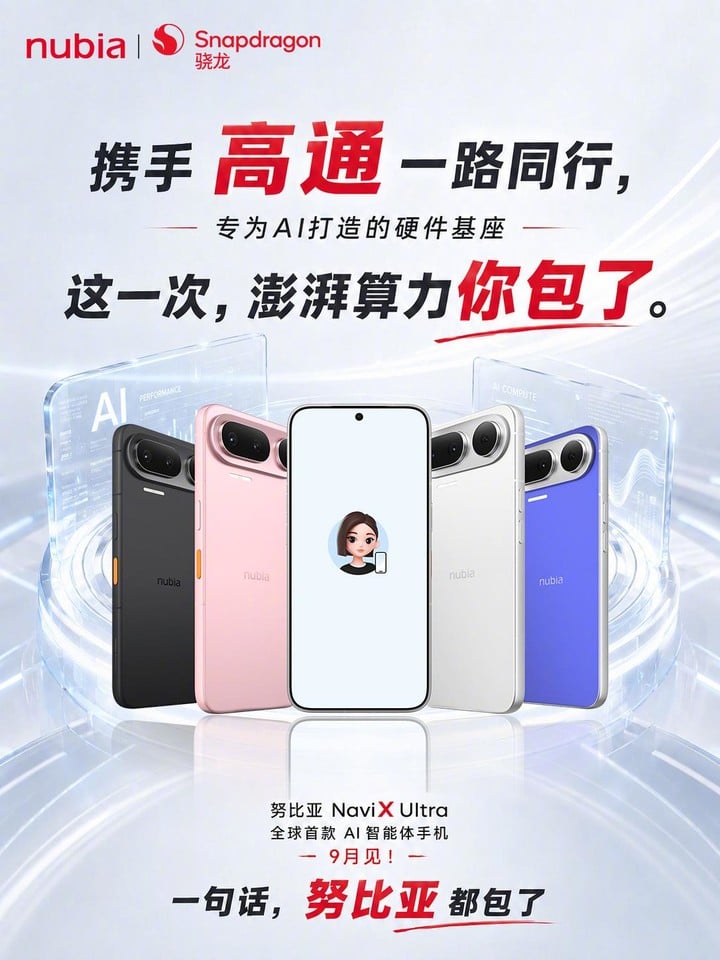
▲ 努比亚 Navi X Ultra AI 智能体手机,搭载高通芯片
AI 智能体手机就要来了,高通想要承前启后
智能手机发展到今天,其实已经很难找到真正独立工作的芯片模块了。按下快门的一瞬间,CPU、ISP、GPU、NPU 都可能参与其中。
游戏也是如此。CPU 负责游戏逻辑,GPU 渲染画面,AI 可以负责超分、帧生成,调制解调器还要维持网络连接。
AI 智能体只是让这种协作更进一步,Sensing Hub 会保持低功耗的环境感知;Oryon CPU 则像一个领班负责规划、推理和编排工作流,决定什么时候调用工具、什么时候访问云端;Hexagon NPU 承担主要的高效端侧 AI 推理;Adreno GPU 则可以参与多模型推理,同时继续完成图形任务。
技术发展的历史往往就是这样,今天那些已经理所当然的体验,最早都曾经是一串无人关心的技术名词。
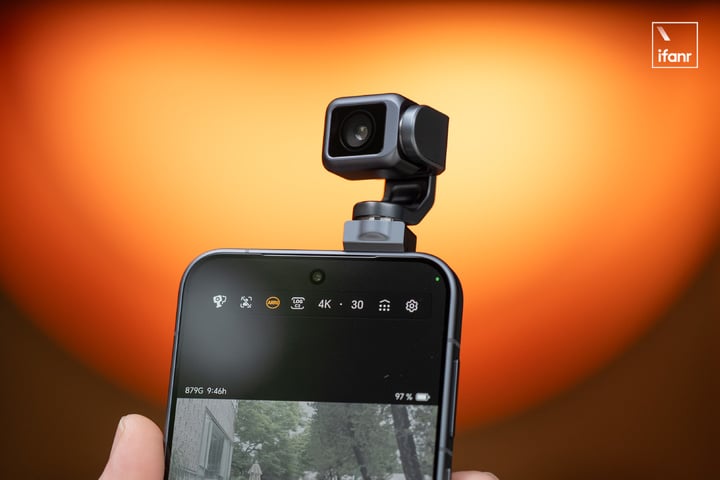
▲ 荣耀 Robot Phone
十几年前,手机厂商第一次开始认真讨论 ISP 时,大多数消费者并不知道 ISP 是什么,后来我们有了「影像旗舰」。
同样的,当时的人们也很难想象一部小小的手机,可以玩主机级的游戏大作,但现在的 GPU 能力支持这么做。
所以高通对于 AI 手机的意义,也许就在这里。即将纷至沓来的 AI 智能体手机,不会在包装盒上写着「采用更大的 KV-cache」,就像影像旗舰也不会在包装盒正面写着 ISP 架构。
用户最终感受到的,只会是:手机更懂你;一句话能完成更多事情。
发生在 CPU、GPU、NPU 和内存之间的复杂调度,最终都会被隐藏起来。就像坐在「潮 1/2」里的客人,不需要知道一道菜从橱柜到案板究竟经过几米。
他们只知道这道菜上来的时候,一切刚刚好。
过去很多年,高通参与定义了手机的影像能力、游戏能力和连接能力。现在,这家名字意思是「高质量连接」的公司开始思考如何更好地连接起 AI 和计算,开始回答一颗真正为 Agent 而生的手机芯片,应该长什么样?
答案是有点难懂的 5GHz 的 Oryon CPU、FlexCache、Adreno Matrix Cores、18MB HPM、更大的 Hexagon 共享内存、以及未来更长期的近存计算探索。
也可以是很简单的那句话:把饭桌搬到厨房那里去。