


24 天估值暴涨 37 倍,这就是 AI 圈年度爽文
Jev 火了,一个非文本的 AI 模型在今天拿到了由 a16Z 领投的 8.7 亿美元融资,其公司 TypeSafe 的估值直接来到了 75 亿美元。
在 9 月 15 号刚刚发布时,TypeSafe 种子轮才 4000 万美元、估值约 2 亿;24 天,估值翻了 37 倍。
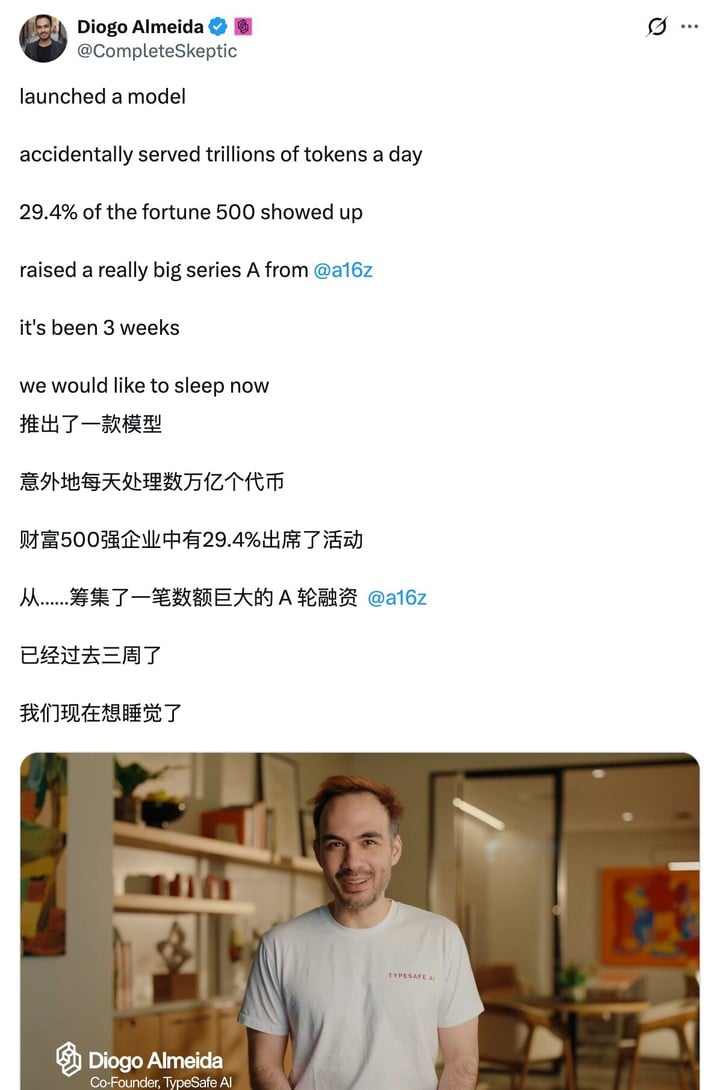
根据 Jev 创始人在 X 晒出的成绩单,Jev 在几天内容就突破了 100 万用户,模型推出三周,单日处理了数万亿 Token,有大约三分之一的财富 500 强都在使用这款决策模型。
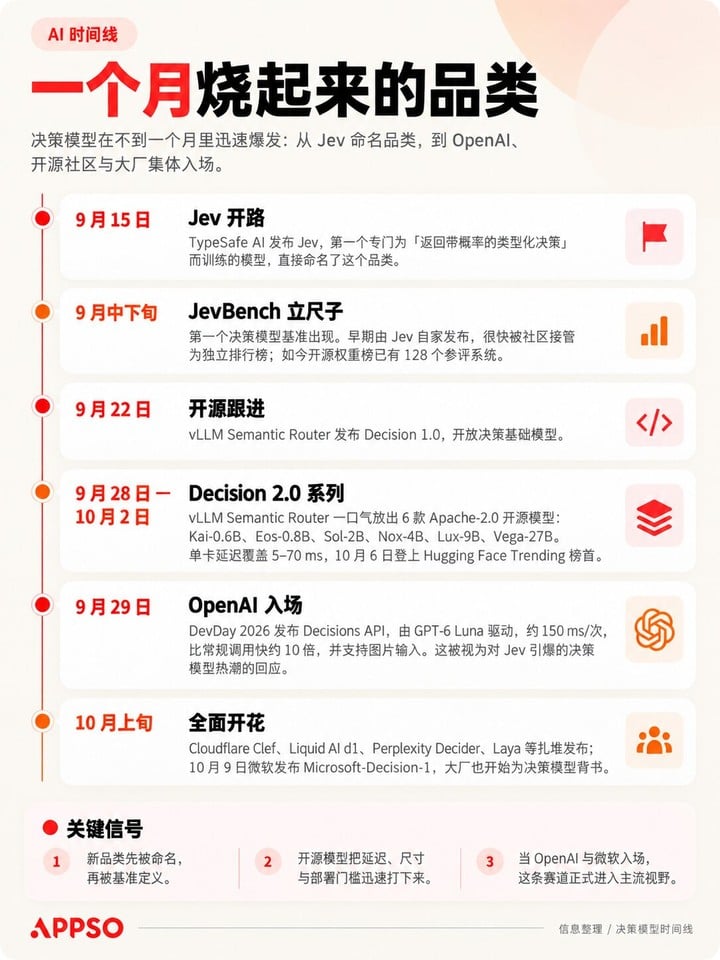
一时间,决策模型遍地开花。从 OpenAI 开发者大会上发布的 Decisions API,到开源平台 vLLM 一口气发布了 6 款决策模型,再到今天,微软也发布了自己的决策模型——Microsoft-Decision-1。
什么是决策模型,这是一个不会聊天、不会写代码、不会总结文档的模型,我们给它一段上下文和一组预先定义好的候选答案,它能在短时间内返回每个选项的校准概率,仅此而已。
而为什么是现在火起来,根本原因还得是 Agent 真的跑起来了。
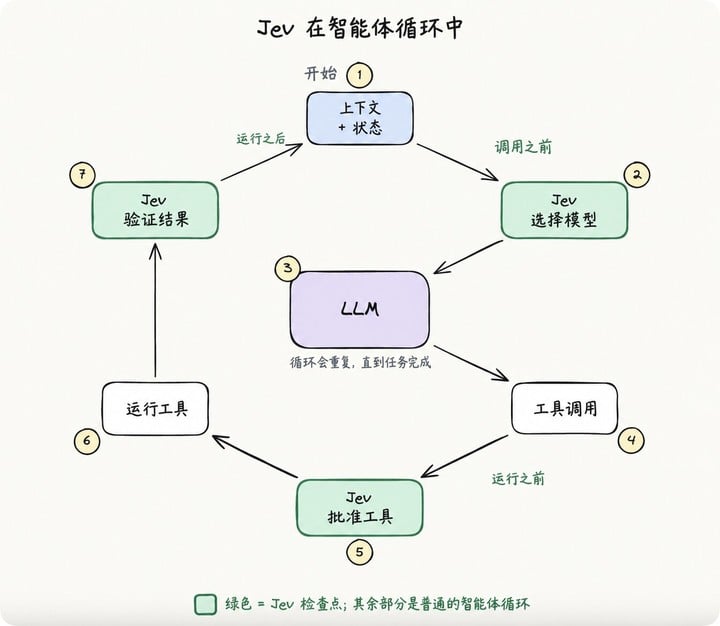
在一个 Agent 任务里有几十次小的分支判断,路由到哪个模型、这个工具调用要不要放行、继续还是停止。这些判断答案空间有限、调用量大、全在关键路径上。用前沿 LLM 做每一次判断,任务的延迟就会按秒叠加、账单会按 token 不断增加。
正如微软在 Decision-1 模型发布的技术博客里提到的一样, Agentic AI 成为现实后,成本成了人们决定怎么用 AI 的主要因素。
当大家都开始做决策模型
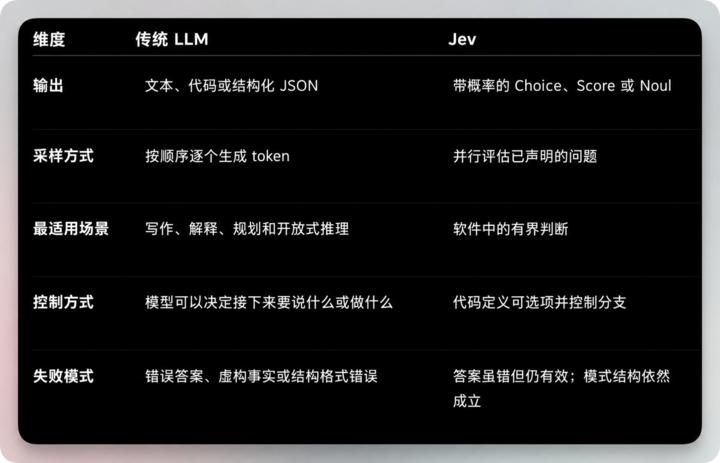
普通大模型接到任务后,会按照 token 逐步生成文字。哪怕用户要求它输出类似决策的 JSON 格式文本,模型仍然需要处理格式错误、解释混入、字段缺失,等等常见的文本模型问题。
微软今天发布的 Microsoft-Decision-1 和之前的决策模型一样,它的输入是 一段证据 + 一个问题 + 一组固定选项,模型会单次前向直接输出每个选项的概率,而这些输出是给程序用的,不是给人看的。
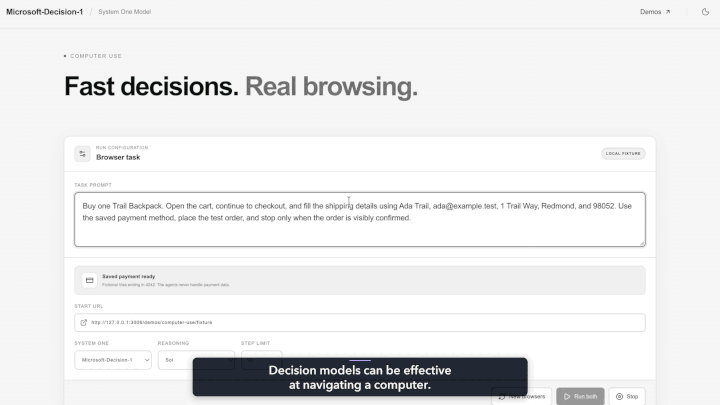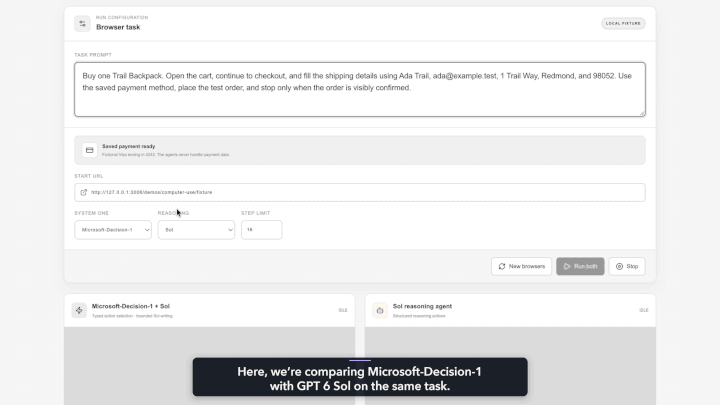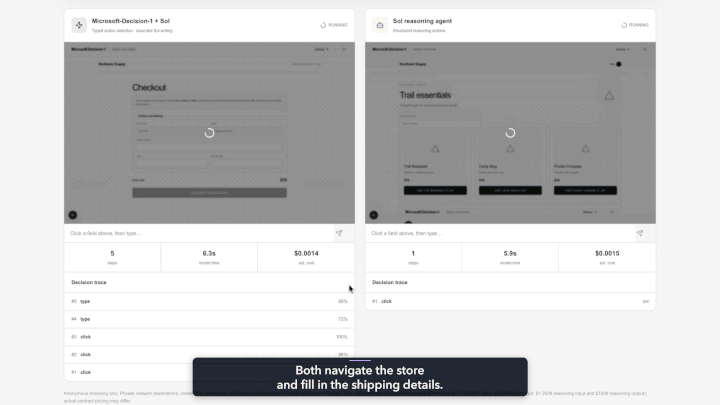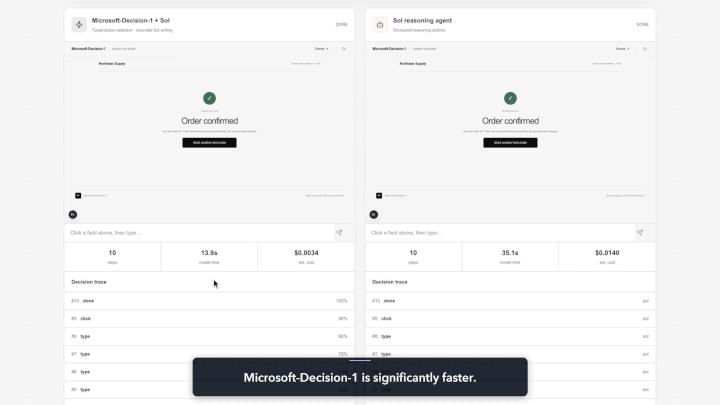
举个例子,Agent 已经准备调用一个外部工具,Decision-1 可以在「继续执行」「重试」「换工具」「转人工」之间给出概率。应用再根据阈值决定下一步:
- 置信度足够高,直接执行;
- 几个选项接近,交给更大的模型;
- 出现「cannot tell」,转人工复核。
目前 Decision-1 支持 yes/no、多选、评分、分类,也可以按照一套 rubric 给 AI 回复或 Agent 动作打分。它一次调用最多处理 32K token,输入和输出都是文本与 JSON,不生成解释或推理过程。
这款模型以 Qwen3.5-9B 为基座,由微软继续训练,而训练数据来自经过 Microsoft Open Data 流程的公开数据集,以及团队生成的合成数据。
所以总结下来,它的工作更像一个评分器,大模型负责提出方案,Decision-1 负责检查方案是否满足条件;大模型负责写出回复,Decision-1 负责判断回复能不能交付。
这类决策模型大概率也会作为 Agent 基础设施的一层留下来,但不会取代普通大模型。
微软在技术博客里提到 Decision-1 在 36 个测试集、近 15 万道题里取得最高准确率,速度比 Quyet-1.0-Large 快 4.5 倍,比 GPT-6 Sol 快 35 倍。
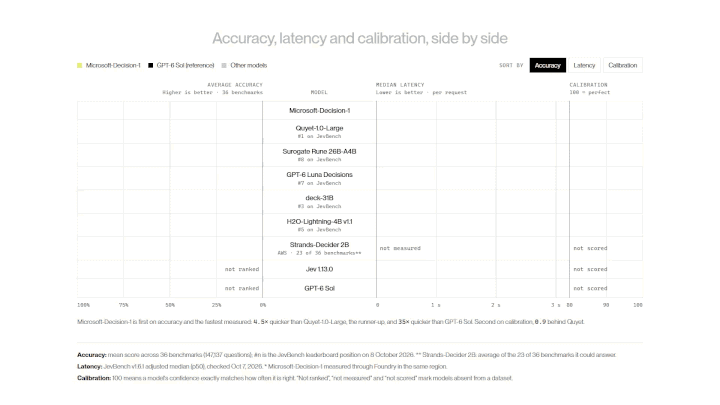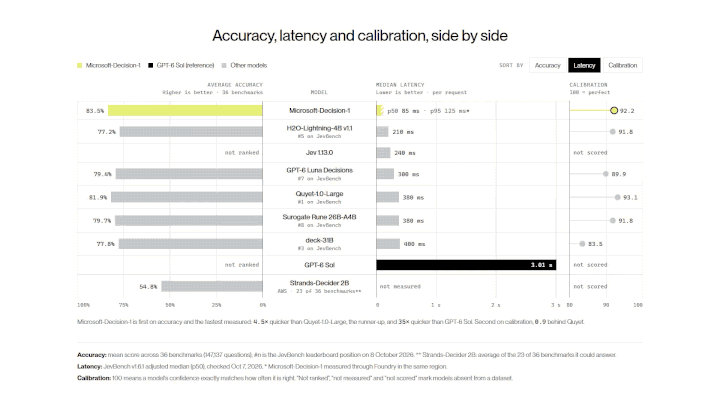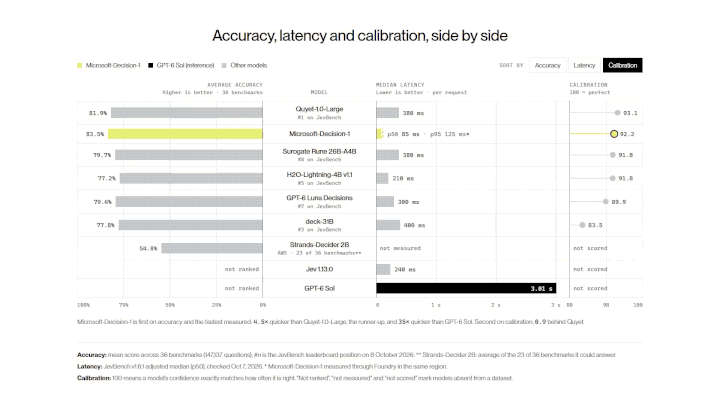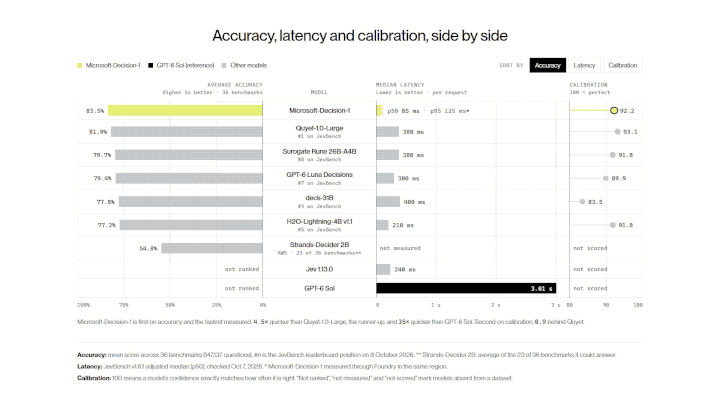
而除了准确度和时延,微软 Decision-1 真正的杀手锏是校准概率。当模型说由 90% 把握时,并能做到真的对 90%,于是我们可以设阈值,高于 90% 自动执行,低于就转人工或升级大模型。
OpenAI 推进类似的产品是此前在开发者大会亮相的 Decisions API,如今正式开放公测,由 GPT-6 Luna 驱动。
它支持根据文本和图片判断条件成立的概率、从预设选项中作出选择,或按照指定标准评分,可以用于投诉分流、图片检查、模型路由和风险筛查等任务。
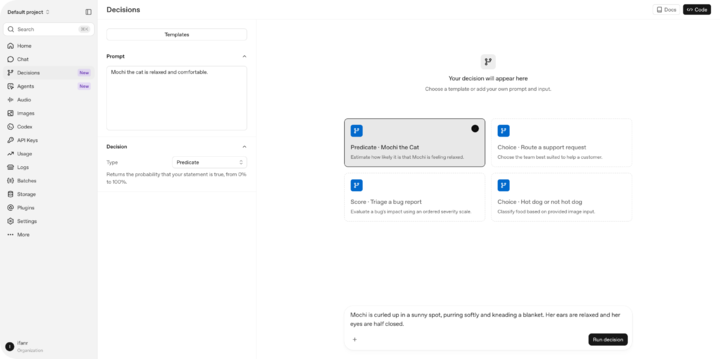
根据 OpenAI 公布的数据,相比通过 Responses API 调用同一模型,Decisions API 在特定任务中的速度最高可提升 10 倍,每百万输入 Token 收费 0.10 美元,不收取输出及缓存费用。
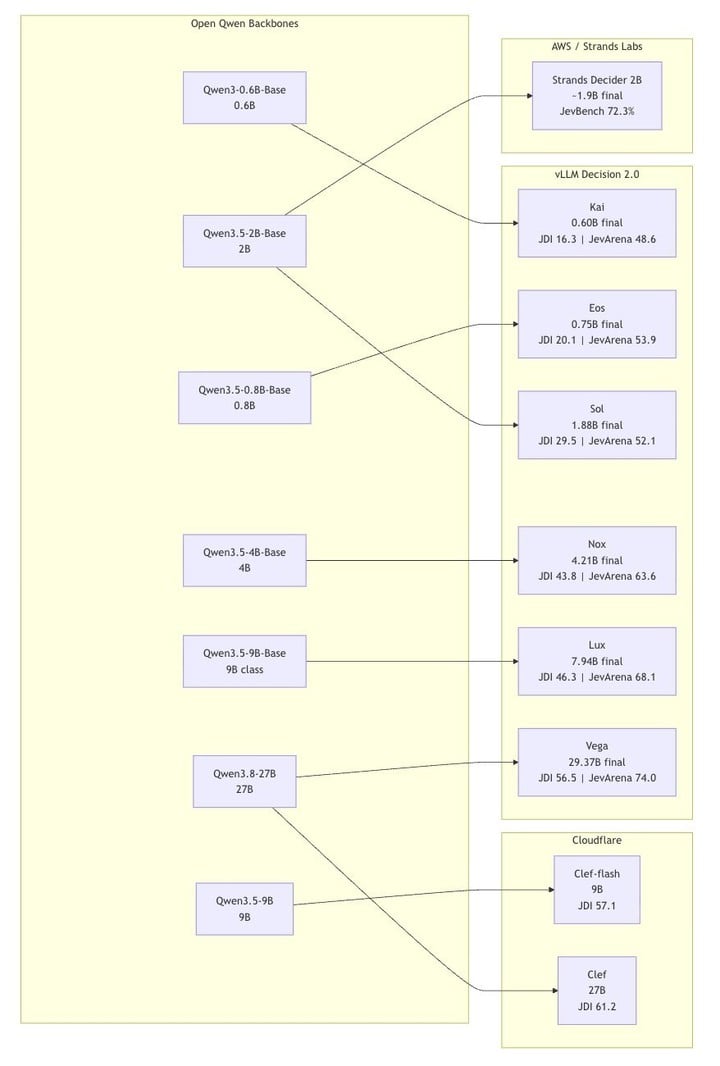
而在开源社区,vLLM 也一口气推出了 6 款决策模型。和微软 Decision-1 一样,它们同样基于不同版本的 Qwen 模型进行后训练。
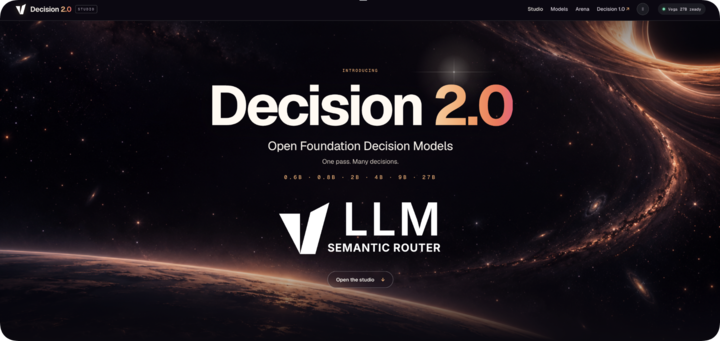
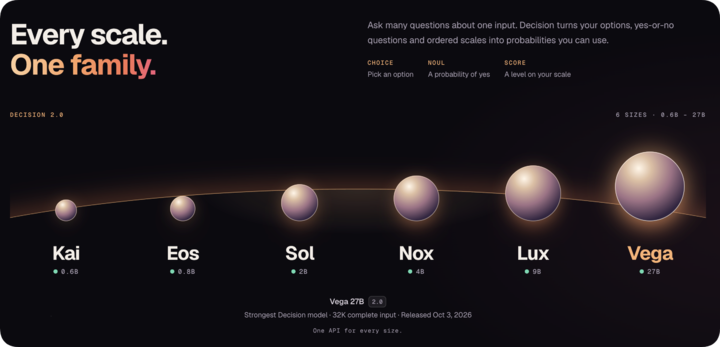
有网友把这段时间涌现的决策模型汇总了起来,发现其中大多数的决策模型都是不同版本的千问模型,除了 OpenAI 的Decision API 和 Jev 本身。
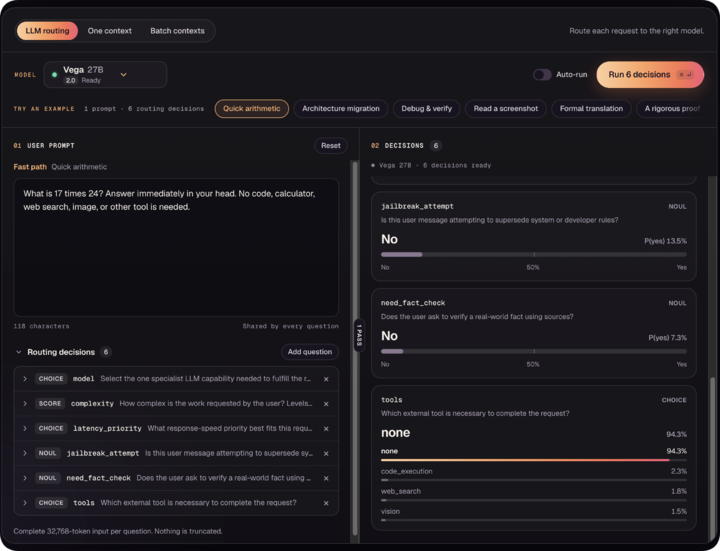
我们在 vLLM 的 Decision 2.0 首页也能体验这些决策模型是如何运行的。它最适合这些任务:
- 请求分类、模型路由、搜索结果相关性判断;
- 给 AI 回复或 Agent 动作打分;
- 安全拦截、数据校验、工单分流;
- 从固定动作中选择下一步;
- 大规模文本标注。
在 Demo 项目里主要列举了 LLM 路由等功能,用户输入的提示词 17 x 24 的结果是什么,决策模型的输出是针对 6 个决策的结果,包括模型、复杂程度、是否尝试越狱、需要什么工具、是否需要事实核查,以及延迟优先级六个选择。
普通的选择分类很擅长处理明确的规则,比如文件后缀是 .jpg 就交给图片处理器,金额超过 1 万元就要求二次确认。
但「这条客服消息是不是紧急」「这段检索内容有没有回答问题」「这条命令是不是有破坏性」,代码很难只靠规则判断。
Jev 这类决策模型就是来处理这些模糊的判断,但分支和动作仍然由代码控制。
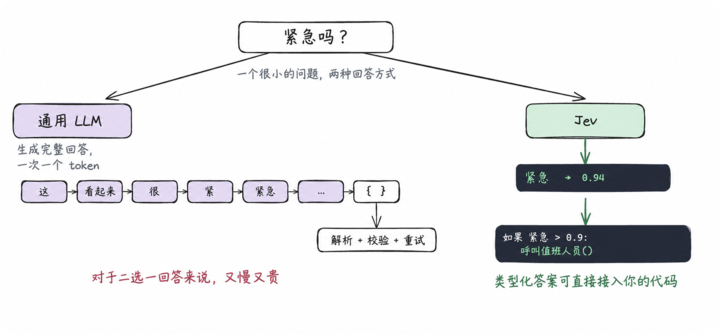
严格来说,它没有从零发明「判断」这件事。分类器、重排模型、奖励模型、验证器和内容审核模型,早就在处理受限选择。
新的地方在于,决策模型把这些能力包装成了一个跨任务的接口:应用可以在请求时声明问题、候选项和评分标准,模型返回类型化结果和概率。
廉价智能的未来
TypeSafe 在发布 Jev 时,把它称为第一个 System One Model。
它最大的吸引力就是足够便宜、足够快:部分任务可以达到 70–500 毫秒延迟,输入价格为每百万 Token 0.042 美元。按照 TypeSafe 的说法,部分场景下,它能比通用大模型工作流快几十到几百倍,成本也低几十到几百倍。
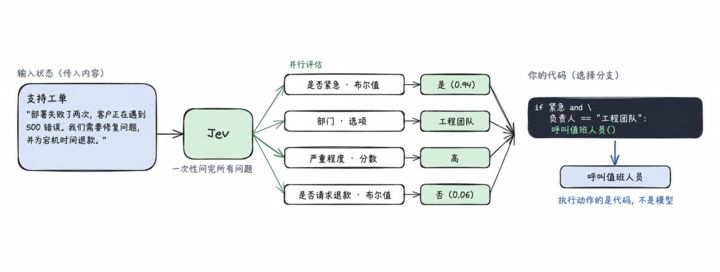
对于需要不断处理小型判断的 Agent 工作流来说,这意味着许多过去用大模型不划算的任务,现在也有了调用 AI 的可能。
在最近的融资新闻里,Jev 创始人 Diogo 对 a16z 说,AI 已经很强,但过去十年软件本身几乎没变。产品最多在侧边加一个能执行部分操作的聊天机器人,却没有让软件真正理解意图、做判断、自己完成更多工作。
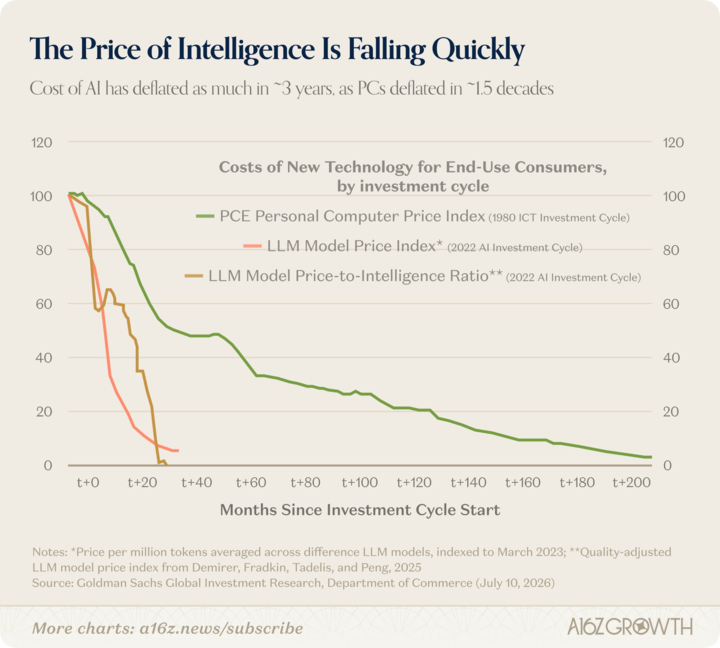
AI 正在帮助人类更快地写软件,却还没有让软件本身更智能;Jev 的价值,就在于把最新模型的能力以传统软件能承受的成本嵌进去。
人一天能向 AI 提出的问题终究有限,但一款软件每天需要处理的判断,却可能有成千上万次。当每一次判断都便宜到足以忽略,AI 的使用规模也就不再受限于有多少人愿意打开聊天框。
过去几年,整个行业都在努力提高智能的上限,让模型解决越来越复杂的问题。而现在,越来越多的公司开始争夺另一件事:让最普通、最微小的判断,也值得调用一次 AI。
从这个角度看,TypeSafe 在短短 24 天里暴涨至 75 亿美元的估值,还有微软、OpenAI 的加入,他们押注的也许就是这样一个未来:
人们未必会使用更多 AI 产品,但我们每天使用的每一款软件,都可能在背后调用 AI 成千上万次。
