


热门搜索
为您查询到 篇文章
9月15日,星期二
9 小时前
全球AI视频榜单第一梯队再添中国力量:智象发布首款物理规律导向视频模型
智象未来(HiDream.ai)正式发布首个原生全模态视频生成模型 HiDream-O1-Video-1.0
今天,智象未来(HiDream.ai)正式发布首个原生全模态视频生成模型 HiDream-O1-Video-1.0(模型简称 HD-V1)。HD-V1采用智象自研原生全模态架构,支持文本、图片、视频等多种模态输入,可一键直出5–20秒1080p高保真视频,同时 在意图理解、物理规律理解、自主规划叙事、以及音画一体化生成等维度均全面升级,达到全球领先水平。
发布同期,HD-V1 在两项国际权威评测榜单中,均位居世界前列。在全球领先的独立 AI 基准测试与分析平台Artificial Analysis Image to Video Leaderboard(With Audio)排行榜上,HD-V1 取得全球排名第四的佳绩。Artificial Analysis 的图生视频榜单以标准化、可复现的基准对全球头部视频生成模型进行系统评测,被视为衡量AI视频模型综合实力的重要标尺。
在全球最具影响力的AI 模型盲测评测平台 Arena.ai Image-to-Video 中,HD-V1也取得了第8的优异成绩。Arena.ai Image-to-Video是专注于AI视频生成模型的盲测评测子平台,是目前评估图生视频模型能力的重要第三方参考,被全球国际主流 AI 厂商广泛引用。
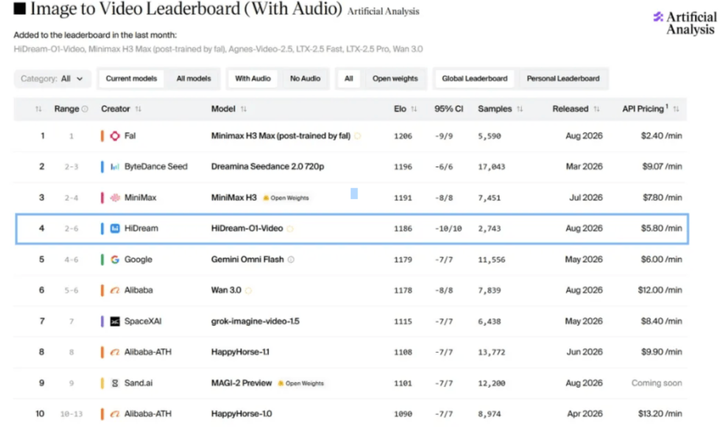
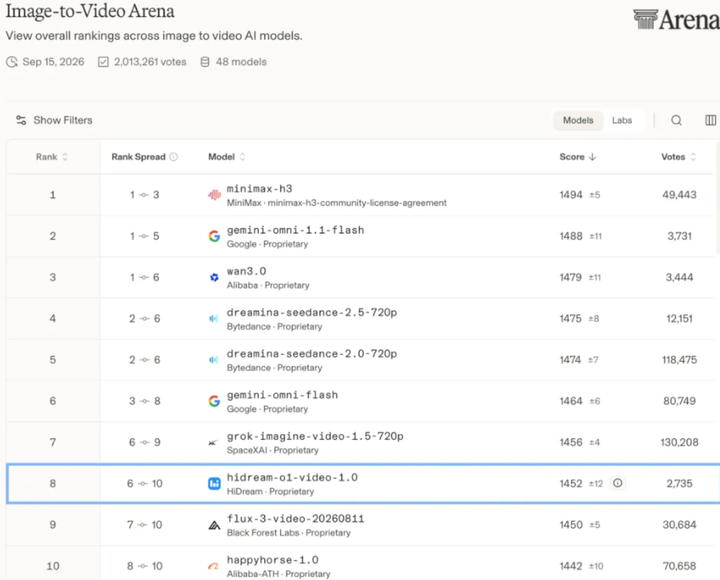
放在全球 AI 竞争格局中看,这一成绩的意义远超名次本身:多模态是当下全球人工智能的核心战场,图生视频则是其中技术密度最高、竞争最激烈的方向之一。HD-V1 以双榜高位成绩完成全球首次亮相,这标志着中国优秀大模型企业已全面领先,形成全球AI视频模型第一梯队 。
智象未来 CTO 姚霆表示:“HiDream-O1-Video-1.0 是智象原生全模态世界模型矩阵的关键组成部分。我们始终相信,视频生成的代际进化不仅仅是像素的提升和时长的延续,而在于模型是否真正理解创作者的意图和真实世界的物理规律。HD-V1从架构设计之初便面向文本、视频与音频的统一表征,原生全模态技术使之从‘看得清、动得顺’,迈向‘听得懂、说得准、演得连贯’。这次在两项国际权威榜单中再次进入第一梯队,是对智象原生全模态技术路线最直接的验证。”
01.原生全模态,更懂意图、更懂物理
视频生成的难点,往往不在“会不会画”,而在“有没有听懂”。用户输入常常是口语化、碎片化、模糊化的信息。直接输入丢给模型,很容易出现意图漏解、镜头跳戏、人物漂移与音画错位等问题。
为此,HD-V1的设计中 前置多模态意图理解模块,借助多模态理解模型的深度理解与思考,对视频内容进行结构化规划。规划内容包括镜头时长、场景地点、画面内容、首帧约束、在场角色、动作与表情、景别构图、运镜焦段、台词与背景声等音效设计等等字段。该模块的存在,保证模型充分理解用户自然语言输入的意图,并转换成模型可接受的专业表达。理解越深,规划越稳;规划越稳,后续联合生成越不容易“跑偏”。
理解意图只是第一步,HD-V1的另一重要突破,是“更懂物理”。
物体在重力作用下如何落下、碰撞如何反馈、惯性如何延续、光影如何衰减、空间如何保持连续——这些物理规律既被理解,也被写进视频模型的叙事之中,成为画面生成的底层逻辑。
当物理规律进入生成逻辑,画面的真实质感得到全面提升。以下三组demo,是在同样的提示词下,三款业内顶级模型生成的视频对比,第三个demo为HD-V1生成(全文均同)。
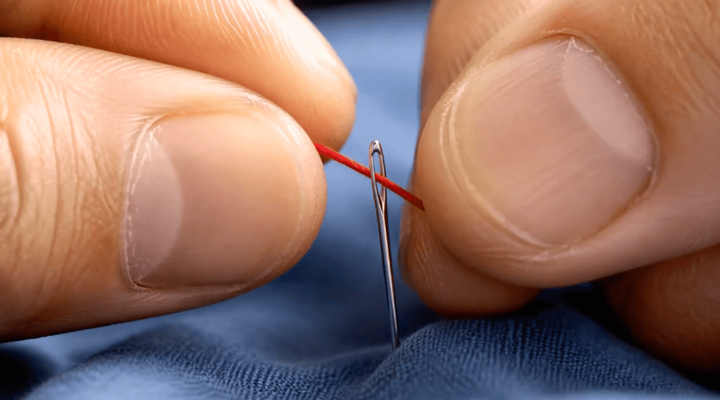
模型一的画面中,双手相向发力,红线产生了向内缩短的“不合理”现象;模型二则突兀地凭空生出一根针。而HD-V1生成的画面截然不同:双手相向发力时,红线自然隆起,与模型一形成鲜明对比;当左手拇指向外轻捻线头,红线便随手的发力顺势延展,张力、走向与形变皆贴合真实物理。而且画面还有着极佳的真实质感,指甲的纹理,针的金属感等都表现得非常真实,甚至从中能感受到线的柔韧。
02.画面高保真、叙事连贯性、人物一致性全面升级
针对高保真画质、叙事连贯性与人物一致性等关键指标,HD-V1实现了全面优化升级。它不只追求单帧画面的精美,更要让视频内容在整体叙事维度上自洽。
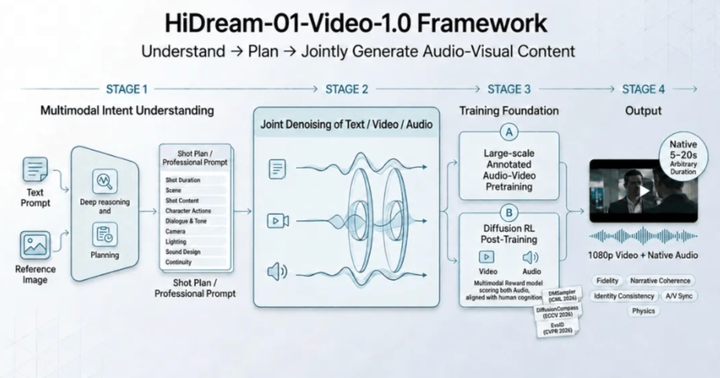
当人物、情绪、动机、物理规律,一旦进入连续镜头,就必然互相影响。为此,智象提出了 “先规划、后联合生成、再以多模态 Reward 对齐”的技术思路 ,让模型先在全局层面规划叙事与角色状态,再在联合生成中约束画面、动作和语义,最后用多模态奖励信号对齐画质、连贯性与物理合理性。
03.服从叙事内容视频生成时长的逻辑革新
多数视频生成时长遵循的是固定提示词路线,比如用户在提示词中输入生成 5 秒,模型只能在这个时间窗口内填充内容,内容叙事“被迫”适应时长。
HD-V1的做法,是 把时长决策交还给内容本身 。模型根据事件展开的逻辑、动作完成的周期、叙事推进的节奏,自行规划生成时长。这一能力的关键,不在于简单改变帧数,而在于把时长选择与内容情境绑定,服务用户真正的目标——在连贯叙事中交付合理、真实质感的完整画面。
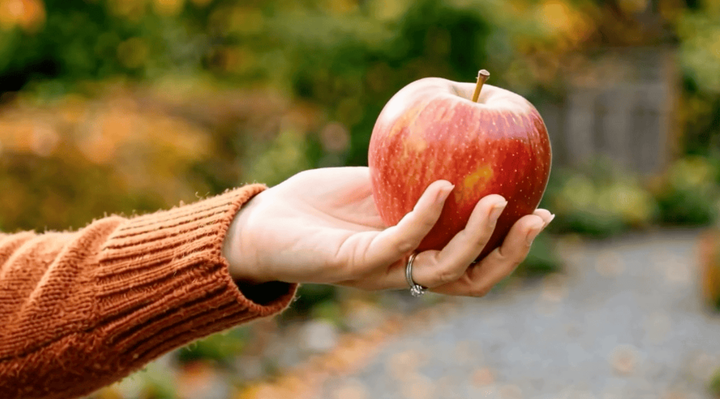
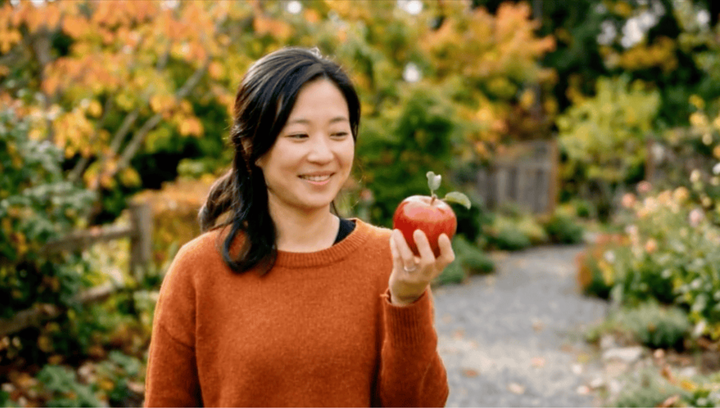
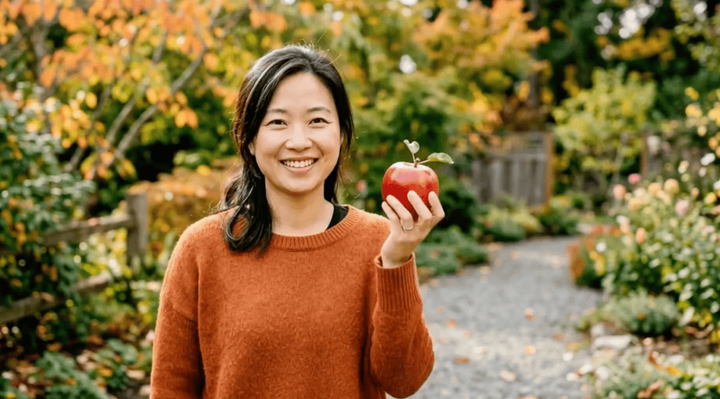
同样是三款模型的真实对比。前两款模型都“机械地”生成了10秒钟画面,但一颗苹果从抛出到接住,本是一个短促的过程,并不需要撑满10秒。于是,模型一在动作完成后,从第三秒起只能让手继续握着苹果,画面停留在无意义的等待里;模型二则用慢放的形式,来填补时长。而HD-V1生成的画面,人物抛出、接住、稳定手持,节奏自然发生。
04.文本、视频、音频信号联合建模音画原生一体化生成
音画不同步是AI视频生成模型的一个普遍通病。这是因为当前多数视频模型采用的后期拼接技术路线:先逐帧生成画面,再回头配音配效,声音跟画面很难保持一致。
HD-V1 采用了原生全模态架构,对文本、视频、音频信号进行联合建模 。三者在同一生成过程中相互约束、相互对齐:画面运动牵引声音节奏,台词与音效反哺镜头情绪,文本条件贯穿始终。这种联合建模,直接服务于音画同步与叙事连贯。镜头切换时,环境声与配乐随之过渡;人物开口时,口型、气口与情绪同频;物理动作发生时,拟音效果与撞击反馈更贴近真实因果。
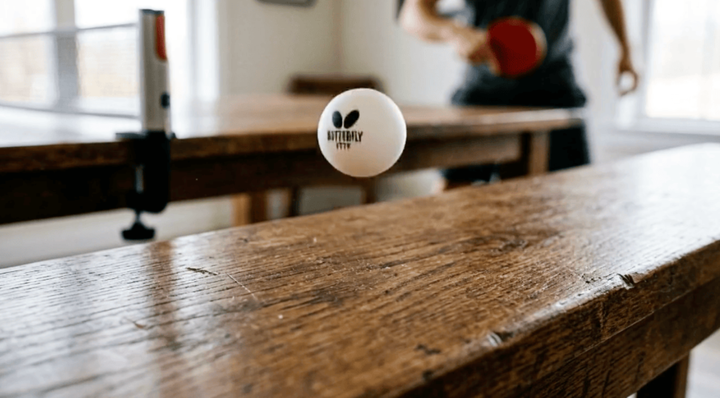
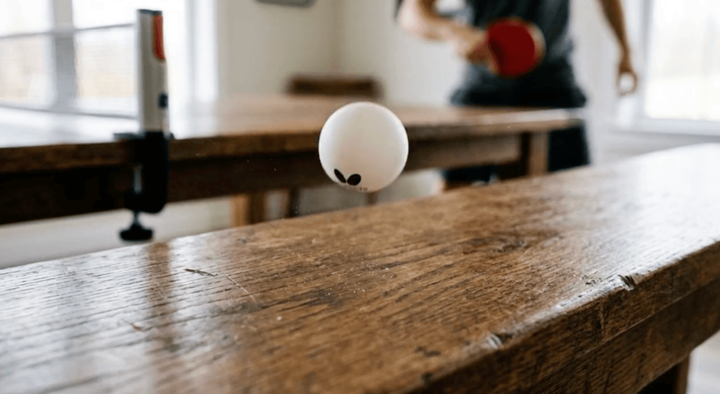
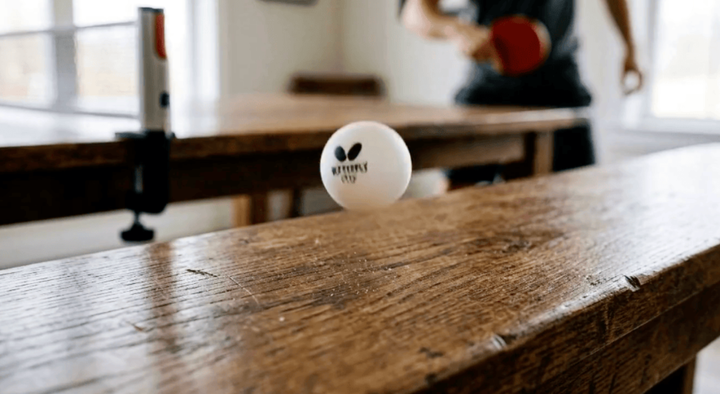
这是一个乒乓球在桌子上弹跳的画面。从三款模型生成的画面来看,只有HD-V1生成的内容,不仅乒乓球掉落的节奏符合物理规律,每次掉落的声音也随着高度的变化而变化,完全符合现实质感。实现真实世界的质感,根源在于模型的技术产品哲学:以人的感受为尺度。为此在后训练阶段,采用 Diffusion Reinforcement Learning,并设计与人工认知对齐的多模态 Reward 模型,对音视频内容进行从画面到声音、从局部到整体的统一评估。
05.世界模型闭环成型从单点能力到原生全模态矩阵
从今年4月正式发布原生全模态世界模型架构HiDream-O1以来,智象陆续发布了基于同一架构的模型家族,这几款模型也分别在各自赛道上取得国际权威榜单的领先位置。
图像生成模型HiDream‑O1‑Image系列 ,其中商用版1.5 版本在国际独立评测平台 Artificial Analysis 文生图榜单中,取得中国第一、全球第二的成绩;开源版本也取得了第二的成绩。
交互式世界模型 HiDream‑O1‑World ,名列行业首个交互式世界模型基准 WBench综合总榜第一。
具身世界模型 HiDream‑O1‑Embodied ,先后在 RoboColiseum的扰动适应和空间推理子榜单中登顶榜首。
随着视频模型正式发布,业内首个原生全模态世界模型闭环就此成型。图像、视频、3D交互与具身动作,在统一原生的世界模型中交汇、共生、循环。
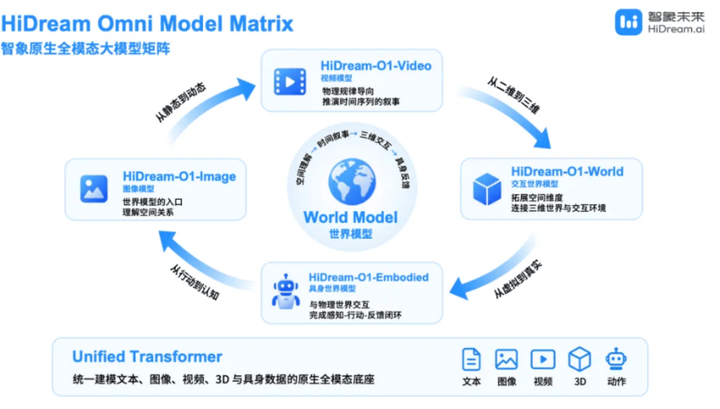
智象创始人梅涛博士表示:“基于我们对下一代人工智能技术路线的认知,智象致力于构建 ‘一个原生全模态底座、四大模型同源演进’的模型矩阵。我们所构建的,不是四条彼此独立的能力线,而是一套以统一技术架构为底座、面向世界模型持续进化走向可落地的原生全模态体系。”
06.C+轮融资落定,国资产业资本组团再加码
在HD-V1发布之际,智象同时宣布完成C+轮融资。本轮投资方为 新微资本、交子资本、工银资本 ,体现了资本市场对公司原生全模态技术路线、世界模型布局及产业化潜力的高度认可。
新微资本由上海新微科技集团、上海科创投集团以及管理团队共同发起成立,管理基金规模近百亿元。作为新微集团的CVC,新微资本正持续加强在人工智能赛道的布局,依托新微集团在集成电路特色工艺制造领域的产业基座,构建在AI时代具备持续竞争力的新微产业生态。
新微资本表示:“智象未来的原生全模态世界模型矩阵,向上连接算力与AI基础设施,向下延伸至智能终端与行业应用,与新微集团的产业布局高度协同。未来新微将以制造能力支撑算力基建,以产业资源加速模型落地,助力智象未来占据世界模型时代的关键席位。”
交子资本是成都交子金控集团旗下全资国有股权投资平台,也是成都建设西部金融中心的重要产业资本载体,管理基金规模超1700亿元。依托成都、辐射西部、链接全国,交子资本聚焦人工智能等硬科技赛道,以长期资本和产业资源推动科技成果转化与产业生态建设。
交子资本相关负责人表示:“智象未来持续推动图像、视频、3D交互与具身四大模型同源演进,围绕底层架构持续创新,构建原生全模态世界模型矩阵。这一路线在行业中具有鲜明的稀缺性和领先性。HiDream-O1-Video-1.0的发布补齐了模型矩阵的关键一环,进一步验证了公司技术路线的前瞻性与落地能力。我们期待发挥国有产业资本的长期陪伴与资源协同作用,助力智象未来成长为具有全球竞争力的AI企业,并带动成都、辐射西部人工智能产业生态建设。”
随着HD-V1视频模型的发布,从原生全模态通往世界模型,不再只是一张战略蓝图,而是闭环发展、持续演进的现实。
加载更多
版权所有 © 以商业目的使用爱范儿网站内容需获许可。非商业目的使用授权遵循 CC BY-NC 4.0。
All content is made available under the CC BY-NC 4.0 for non-commercial use. Commercial use of this content is prohibited without explicit permission.
Designed by
if Design Studio.
关注 if Design Studio.
微信扫码关注公众号 if Design Studio.